무 썰듯 나눌 수 없어서
2편에는 왜 초씨역림을 끌어왔는지를 적었습니다. 이 글은 그 4,096편을 실제로 어떻게 옮겼는지, 작업대 위의 이야기입니다.
직역으로는 와 닿지 않아서
원문을 가져온 중국 고전 사이트에는 영어 번역도 함께 실려 있었습니다. 그런데 글자 하나하나에 충실한 직역이라, 맨 첫 편부터 무슨 말인지 금세 이해가 가지 않았습니다.
그래서 처음에는 타로카드처럼 중세 영어 풍으로, 또는 격언처럼 옮기되 배경지식의 보충 설명이나 해설을 덧붙여 직역의 어색함을 덜어 보려 했습니다. 작업해 놓고 보니 얼핏 그럴듯하긴 했지만, 중세 영어 낱말이 섞인 글을 과연 몇이나 읽을까 싶었습니다. 번역에 자신이 없으니 문장 스타일을 특색 있게 강조하여 권위를 가장하고 싶었나 봅니다.
다듬는다는 것이 결국 최대한 친절한 어르신처럼, 인디언 노인이나 마스터 요다의 격언이라도 흉내 내는 쪽이 되었습니다. 직역의 모호함이 원래 의도한 것도 아니다 보니, 풀어낸 해설은 자연스럽게 좀 더 편안한 Dear Abby 상담 글처럼 되어 버렸습니다. 옛 책에 자주 나오는 고사 속 인물과 지명도 영어로 읽는 사람에게는 벽이 되기에, "앞서 간 이"나 산과 강처럼 누구나 떠올릴 수 있는 이미지로 바꿔 옮겼습니다.
재미있는 점은 한국어 쪽이었습니다. 한글 번역을 먼저 하려 하면 습관처럼 시험지 문항 해설이나 고문 참고서처럼 각주가 끝없이 붙었습니다. 그래서 모국어가 아닌데도 영어 작업을 먼저 하고, 그것을 다시 한국어로 옮기는 상황이 펼쳐졌습니다. 그 덕에 의도치 않게 한국어는 직역도 해설도 아닌, 뭔가 시구 모음처럼 멋을 부린 문체가 되었습니다.
흐린 표와 목차
길흉표를 참고하게 된 것도 같은 고민에서였습니다. 원문에 충실한 해석은 다 읽고 나면 좋은 말 같은데, 결국 이게 나와 무슨 상관인가 싶어졌습니다. 그래서 의역이나 해설의 방향을 잡는 데 참고하려고, 『도해 초씨역림』 같은 입문서 부록의 요약표를 견본으로 삼았습니다. 시 한 편마다 네 글자 요약과 길(吉), 흉(凶), 평(平)이 적힌 표입니다. 처음부터 길흉을 밝혀 적는 것이 우선은 아니었습니다.
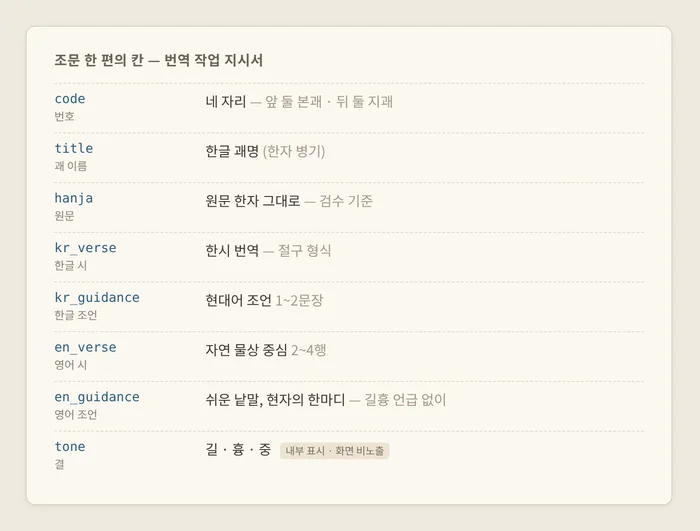
그런데 데이터 묶음을 다루다 보니 사정이 달라졌습니다. 번역한 파일 묶음을 JSON이라고 부른다는 것도 이때 알았는데, 자료를 칸마다 규정하는 데이터의 성격 때문인지 AI는 틈날 때마다 이 시를 길로 둘지 흉으로 둘지 확인을 요구했습니다. 당혹스러운 스트레스였습니다.
결을 정하는 데 필요한 것은 칸마다 길, 흉, 평 한 글자뿐이었고, 그 한 글자는 굵은 괄호 안에 있어 흐린 페이지에서도 대개 살아 있었습니다.
그래도 다 읽히지는 않아서, 괘마다 이미지를 두 장씩 만들어 두었습니다. 한 장은 길흉표, 한 장은 같은 네 글자 요약이 다시 적힌 목차입니다. 표가 흐린 칸은 목차의 요약으로 짐작해 메워 왔습니다. 128장을 따로 문서로 옮겨 적어야 하나 은근히 고민했는데, 두 장이 서로를 메워 주니 그럴 필요가 없었습니다.
표가 흉이라 해도
표는 어디까지나 1차 참고였고, 최종 판단은 원문을 끝까지 읽고 하기로 했습니다. 해설서의 네 글자 요약이 원문의 맥락과 다른 경우가 있었기 때문입니다.
첫 괘부터 그런 시가 나왔습니다. 건괘가 둔괘로 가는 시는 표에는 흉으로 찍혀 있었지만, 원문은 한동안 기울고 잃는 고생 끝에 마침내 바라던 짝을 만나는 것으로 맺습니다. 곤괘가 수괘로 가는 시는 표에는 편안한 잠으로 요약되어 있었는데, 원문에 나오는 긴 밤의 방과 제기는 본래 장례의 이미지였습니다. 표와 원문이 정반대인 셈입니다.
처음에는 이런 시가 나올 때마다 하나씩 따져 정하려 했습니다. 원문의 문맥과 맞지 않는 길흉 표시는 두고두고 주의할 거리가 되었습니다. 그러다 마음을 바꿨습니다. 주역의 괘사와 효사도 길흉을 나누기 어려운 대목이 많은데, 깊이 얕은 제가 길흉을 결정할 수는 없었습니다. 그래서 표와 원문이 엇갈리면 모두 평(平)으로 두기로 했습니다.
다만 얼버무리는 평이 아니라, 길하게도 흉하게도 열려 있는 평이기를 바랐습니다. 비 아니면 맑음이 아니라, 비 오는 사이에도 비치는 햇살처럼. 현실 자체가 새옹지마라 무 썰듯 나눌 수 없으니까요. 지금 화면에서 시 옆에 붙는 이름도 그 생각을 따랐습니다. 길은 순(順)으로, 흉은 한 번 누그러뜨려 비 사이로 햇살로, 길흉을 모두 지닌 평은 양면(兩面)으로 적습니다. 처음에는 화면에 보이지 않는 내부 표시였던 결이 그렇게 이름을 얻었습니다.
원문을 펼쳐 보니
작업은 한 번에 본괘 하나, 64편씩 예순네 번으로 나눴습니다. 원문 한자를 빠뜨리고 맡기면 AI가 그럴듯한 시를 새로 지어 오기 때문에, 한자 원문은 반드시 함께 넣고 결과의 원문 칸이 넣은 글자와 같은지부터 확인했습니다.
원문 파일을 정리하는 데서도 작은 발견이 있었습니다. 4,096편이 빠짐없이 들어 있긴 했지만, 번호 뒤의 구분이 어떤 곳은 빈칸, 어떤 곳은 탭으로 섞여 있었습니다. 기제괘 쪽에는 번호 하나가 한 자리 빠진 채 적혀 있었고, 각 괘 묶음은 번호 순이 아니라 자기 괘가 맨 앞에 오는 순서였습니다. 사람 눈으로 읽을 때는 아무 문제 없던 것들이, 기계에게 읽힐 때는 하나하나 걸림돌이 되었습니다.
화면에서 시 한 편을 열 때마다 보이는 것은 원문과 한글 시, 영어 시와 조언 몇 줄이지만, 그 뒤에는 흐린 표 한 장과 목차 한 장, 그리고 무 썰듯 나눌 수 없던 고민이 하나씩 겹쳐 있습니다.